Sound Source Detection & Localization - SSDL
声学无人机检测与定位
模型演示
检测和定位模型演示:
无人机存在检测模型用于判断音频中是否存在无人机;
无人机固定阵列DOA计算模型从音频中估计无人机方向、距离和俯仰角等。
页面中的预置样例来自于未参与训练的测试集。
8 CH
N · 0°
E · 90°
S · 180°
W · 270°
DATA & PROTOCOL
数据、任务与协议
规模指整个公开数据集的样本数。
| 数据集 | 任务 | 数据集总规模 | 输入规格 | 评估协议 |
|---|
片段级检测
使用论文的随机划分方式,主要用于复现论文,可能存在数据泄露问题。
严格分组检测
同一个声源片段不跨集合,是部署模型选择和报告的正式协议。
同录音时间切分
使用论文的划分方式,训练和测试来自相同录音与位置,可能存在数据泄露问题。
位置分组 5-fold验证
测试位置在对应折(fold)训练中从未出现,用于考察空间位置泛化性能。
PIPELINE
两条独立推理链
本地音频预置音频样例
16 kHz单通道 · 1 s
log-mel64 bins
CRNNCNN + 2-layer GRU
存在概率连续2窗口聚合
项目说明
Drone Detection
D2 CRNN / log-mel
判断音频中是否存在无人机。
16 kHz · mono
模型详细信息
在线样例:D2 seed-37 test测试样例共1756条(无人机200、非无人机1556)。标签只用于推理结果对比。
INPUT
选择检测样例
INTERNAL AUDIO选中音频播放
—INFERENCE
检测结果
尚未运行
选择样例后开始检测。
正在检测
读取音频、计算log-mel,并使用CRNN与阈值完成推理。
聚合概率—
0阈值1
输入与采样信息
概率、阈值与标签
结论:D2 log-mel是正式部署模型;D1与D2的数据划分方法不同,不能跨协议对比。
| 协议 | 模型 | 重复实验次数 | Accuracy | macro-F1 | 说明 |
|---|
结论:风噪的平均误报率最高,但误报全部集中在seed 73,说明不同运行之间波动较大。链锯和飞机都只在一次运行中出现过一个误报窗口,目前还不能认为模型对这两类声音存在稳定的识别问题。
| 负样本类别 | 窗口误报率(均值±标准差) | 各次运行的误报情况 |
|---|
本地 WAV音频输入
重采样16 kHz · mono
滑窗1 s / 0.5 s
64-bin log-mel25 ms / 10 ms
CNN 前端局部时频特征
2 层 GRU时间聚合
结果推理阈值 0.816571
FIXED ARRAY · U1 ONLINE CHECKPOINT
UaVirBASE固定阵列DOA
在已知含无人机的八通道录音中进行方向估计。
96 kHz · 8 ch
模型详细信息
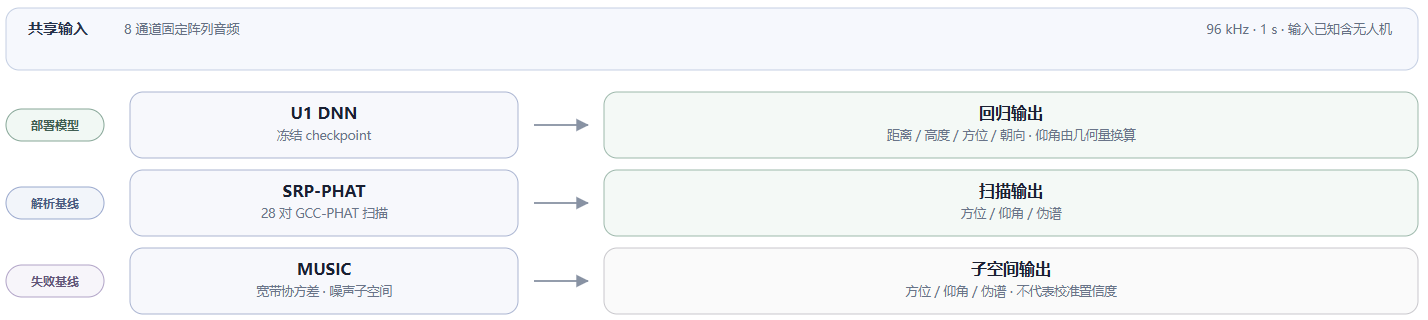
定位入口:UaVirBASE DNN、SRP-PHAT、MUSIC和三模型对比。其中DNN使用U1 checkpoint。
INPUT
选择模型与录音
3D DIRECTION
East / North / Up
拖动旋转 · 滚轮缩放
尚未运行
运行后显示预测方向与真值。
正在执行DOA计算
按所选定位器读取音频并计算方向。
INTERACTIVE VIEW
拖动旋转 · 滚轮缩放三维方向坐标
DNN仰角由预测距离、高度和阵列中心高度换算;SRP-PHAT/MUSIC使用直接估计仰角。
输入、通道与阵列检查
DOA、谱峰相对突出度与耗时
结论:U2显示DNN距离、高度和朝向在未知位置显著退化;SRP-PHAT较稳定但方位精度较低;MUSIC在U1和U2两个阶段的精读均未达到要求。
| 方法 | 协议 | 方位 MAE | 距离 MAE | 高度 MAE | 朝向 MAE | 说明 |
|---|
结果概览:DNN在未知位置测试(U2)中的距离、高度和机身朝向误差明显增大。UaVirBASE另有4段不含无人机目标的环境噪声录音,它们没有位置真值,只用于观察无目标输入下的模型响应,不参与定位精度统计。
| 方法或数据 | 评价内容 | U1→U2结果 | 说明 |
|---|
TRANSFERABILITY STUDY
NeuralMUSIC 思路迁移
验证混合神经-子空间的设计方法能否迁移到UaVirBASE数据集。
上游 NeuralMUSIC4/16 ch · 16 kHz
+X / 逆时针
+X / 逆时针
不可直接迁移通道 / 几何 / 频带
训练 / 坐标不一致
训练 / 坐标不一致
UaVirBASE B18 ch · 96 kHz
North / 顺时针
North / 顺时针
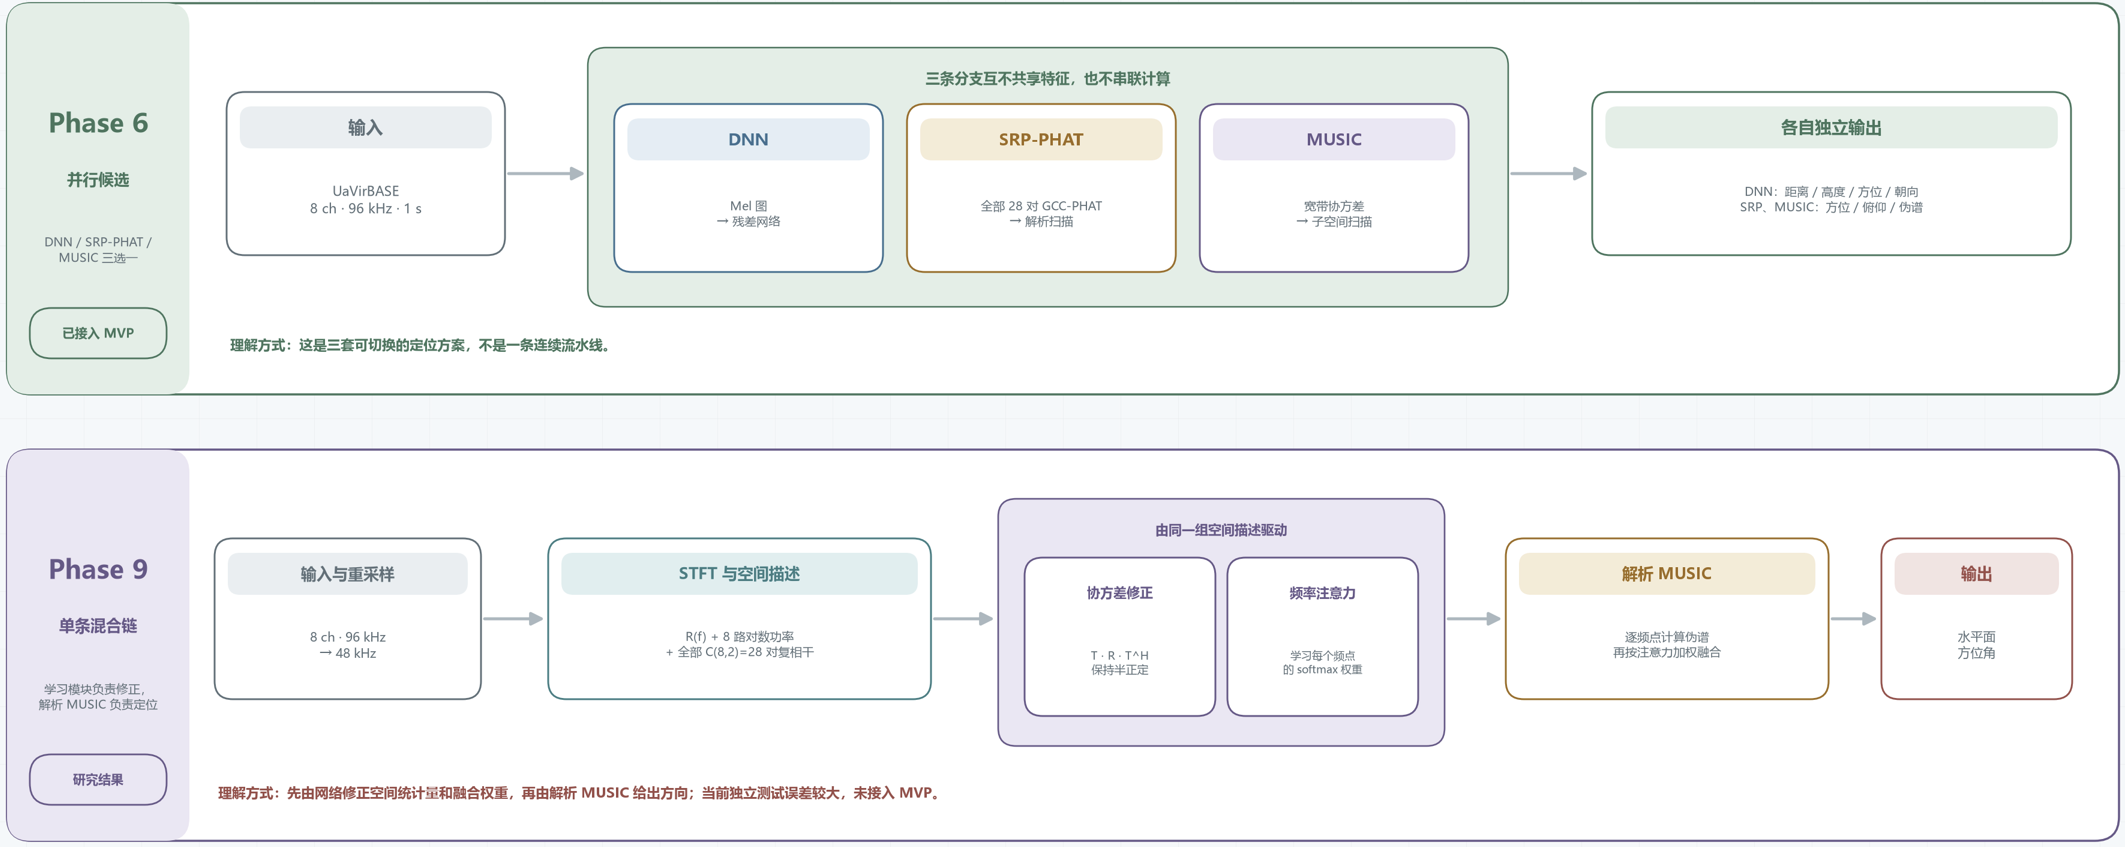
UaVirBASE前向接口协方差修正 · 频率权重
混合神经-子空间方法推理精读不达标
结论:这一部分验证了混合神经-子空间的迁移接口,但训练得到的模型在U1/U2上的检测结果都不如DNN。
| 方法 | 用途 | 可训练参数量 | U1方位MAE | U2方位MAE |
|---|
注:表中指标为方位圆周MAE,数值越低越好。表中的混合神经-子空间模型是借鉴NeuralMUSIC思路、面向UaVirBASE独立实现的研究模型,不是NeuralMUSIC的复现。它在验证集上表现出一定的学习效果,但在U1和U2上检测误差仍然很大。
最终判断:本阶段只验证迁移适配性。由于上游未提供可完整复现的原始训练代码,项目借鉴算法思想并按 UaVirBASE 的 8 通道阵列、96 kHz 采样率和坐标约定独立实现;负结果不通过测试集调参掩盖。
Phase 8–9 只读复现命令
export UAD_DATA_ROOT=/path/to/organized-data
uv run python scripts/run_neuralmusic_b1.py --help
uv run python scripts/run_phase9_hybrid.py audit
uv run python scripts/run_phase10_delivery.py audit
PROTOCOL & PROVENANCE AUDIT
系统基准与冻结证据
把协议、checkpoint、结果、延迟和哈希放在同一视图,防止跨协议误比较和展示漂移。
SHA-256
检测协议结论:D1 用于论文式片段级比较;D2 用于源代理严格分组和部署选择。最终 D2 seed 37 阈值 0.816571 只由验证集确定,UaVirBASE 演示漏检不会触发降阈值。
| 协议 | 模型 | 运行 | Accuracy | macro-F1 | 上下文 |
|---|
定位协议结论:U1 是同录音时间泛化,U2 是严格未知位置 5-fold。DNN 的距离、高度、朝向在 U2 显著退化;MUSIC 即使 U2 数字低于 U1,仍不可称为改善。
| 方法 | 协议 | 方位 MAE | 距离 MAE | 高度 MAE | 朝向 MAE | 说明 |
|---|
LATENCY
延迟与资源
10 次预热、100 次计时;设备、batch size 和文件读取边界必须与数字一起阅读。
| 方法 | 设备 | median / P90 | 上下文 |
|---|
INTEGRITY
受信来源与完整性
页面不会重新训练、调整 D2 阈值、改变 UaVirBASE 通道顺序或写回冻结结果。输出只包含项目相对路径与 SHA-256,不暴露服务器绝对路径。
点击“读取来源哈希”后显示。